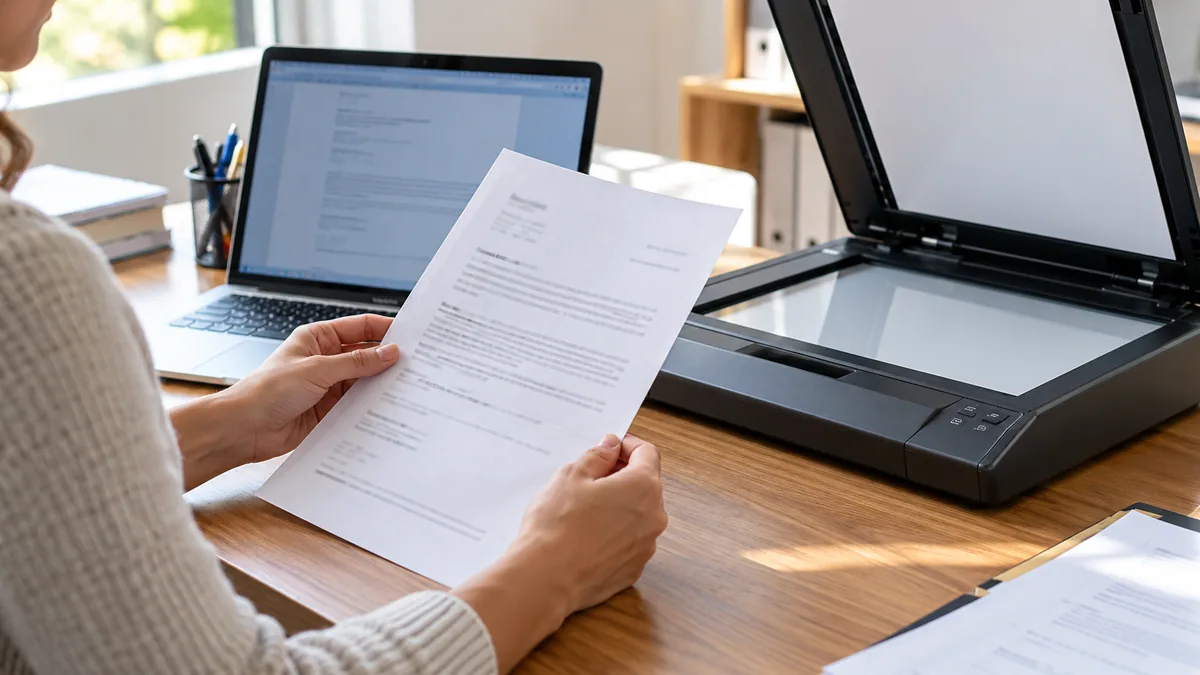
Le nom est bien sur la page. Vous le voyez, vous le lisez, mais la recherche du lecteur PDF ne trouve rien. Le document n’est pas forcément défectueux : il peut simplement contenir une photographie de chaque feuille, sans texte exploitable par le logiciel.
C’est la différence entre voir des lettres dans une image et disposer de caractères que l’ordinateur peut rechercher, sélectionner ou copier. L’OCR fait le lien entre les deux. Il ne garantit toutefois pas que tout ce qu’il reconnaît est exact.
Une page lisible pour vous peut rester une image pour le logiciel
Lorsqu’un scanner ou un téléphone produit un PDF, il peut placer les images des pages dans un fichier. Le résultat ressemble à un document classique, mais son contenu n’a pas nécessairement la structure d’un texte créé dans un traitement de texte.
Un premier diagnostic consiste à rechercher une expression bien visible, puis à essayer de sélectionner un mot. Si rien ne répond, une absence de couche textuelle est possible. Ce n’est pas la seule cause : des restrictions, un encodage particulier ou un document composite peuvent aussi compliquer l’extraction.
Évitez donc de conclure uniquement parce que le fichier porte l’extension PDF. Ce format peut réunir texte, images, formulaires et autres éléments. Deux pages du même fichier peuvent même fonctionner différemment si elles proviennent de sources distinctes.
Le PDF est un contenant, pas une promesse de texte sélectionnable.
L’OCR ajoute une interprétation de ce qui est imprimé
La reconnaissance optique de caractères, ou OCR, analyse les formes présentes dans l’image et propose des caractères. Selon les outils et les options, elle peut créer une couche de texte recherchable tout en conservant l’apparence de la page numérisée.
Ce fonctionnement explique une situation surprenante : la page peut paraître parfaite alors que le texte copié contient une erreur. L’image montre le bon montant ; la couche reconnue contient un chiffre différent. La recherche et la copie utilisent alors une interprétation qui n’est pas toujours celle que vous lisez visuellement.
Choisir la langue adaptée aide le traitement. Une page floue, inclinée, ombrée ou peu contrastée reste cependant plus difficile à analyser. L’écriture manuscrite et les présentations complexes demandent aussi une prudence particulière. Lorsque l’image de départ est mauvaise, une nouvelle numérisation peut être plus efficace qu’une longue correction.
Les chiffres et les noms méritent une vérification à part
Un « O » peut être confondu avec un zéro, un caractère disparaître ou une ponctuation changer. Ces erreurs ont des conséquences différentes selon le document. Une coquille dans une phrase descriptive ne pèse pas autant qu’un numéro de compte, une référence ou une date erronés.
Avant de réutiliser le texte, comparez avec l’image les informations sensibles : montants, unités, dates, noms et identifiants. Une recherche réussie ne prouve pas que toutes les autres pages ont été correctement reconnues.
Les tableaux demandent un contrôle supplémentaire. Le contenu peut être lu dans un ordre différent de celui attendu, avec des valeurs rattachées à la mauvaise colonne. Un collage dans un tableur n’est donc pas automatiquement une extraction structurée fiable.
Pour un document important, gardez l’original et travaillez sur une copie. Vous pourrez retrouver la source si une correction ou une conversion a modifié le fichier.
Reconnaître le texte ne reconstitue pas toute la mise en page
L’OCR ne transforme pas nécessairement un scan en document éditable comme l’était son fichier d’origine. Le logiciel peut reconnaître les mots sans retrouver exactement les paragraphes, styles, tableaux et relations entre les éléments.
Une modification importante peut donc décaler la présentation ou demander une reconstruction. Si vous avez accès au fichier source, il est souvent préférable d’y corriger le contenu, puis de produire un nouvel export. L’OCR est surtout utile lorsque ce fichier n’existe plus ou n’est pas disponible.
Il ne rend pas non plus automatiquement le document pleinement accessible. Un texte reconnu peut rester sans ordre de lecture logique, sans titres structurés ou sans description des images utiles. Ces besoins dépassent la seule reconnaissance des caractères.
Un contrôle simple avant d’envoyer le document
Après traitement, recherchez plusieurs termes répartis dans le fichier. Copiez un court passage dans un éditeur de texte et vérifiez son ordre et ses caractères. Examinez ensuite un tableau ou une zone difficile, si le document en contient.
Ne remplacez pas cette vérification par la seule annonce « traitement terminé ». Elle confirme une exécution, pas l’exactitude de tous les résultats.
Une recherche peut aussi manquer un nom parce qu’il a été mal reconnu, alors que d’autres mots fonctionnent. Essayez un terme simple et un élément plus difficile avant de relancer tout le traitement. Si plusieurs pages ont des orientations ou langues différentes, vérifiez les options appliquées à chacune.
Pour une extraction de liste, contrôlez quelques lignes du début, du milieu et de la fin. Une colonne déplacée peut laisser des mots exacts mais produire une information fausse lorsqu’ils sont associés. La qualité ne se résume donc pas à l’absence de caractères étranges.
Le choix du service compte aussi pour un document confidentiel. Un outil en ligne peut demander l’envoi du fichier à un prestataire. Vérifiez les conditions de traitement et de conservation avant d’y déposer des données personnelles ou professionnelles sensibles.
La bonne question n’est donc pas seulement « puis-je chercher dans ce PDF ? », mais aussi « puis-je me fier au texte que j’en récupère ? ». L’OCR ouvre l’accès à l’information ; la comparaison avec la page d’origine reste le contrôle décisif lorsqu’un détail compte.
La discussion